1. Introducción y problema
En el tramo 2021–2026 el mercado de «agentes de IA» ha instalado un paquete de artefactos que pretenden valer por arnés (harness) de producción: un modelo más grande que «ya razona»; un prompt ReAct o una plantilla con tools que «ya actúa»; una demo de API o function calling sin bucle de observación–acción–verificación; un chatbot etiquetado agent porque recuerda el hilo o recupera documentos (RAG); un fine-tune presentado como control de ejecución; y un ranking de benchmark sin describir la interfaz agente–computadora, los verificadores, los presupuestos ni el aislamiento. Los artefactos caben en una diapositiva. El salto —de escala, prompt, demo, marketing o leaderboard a afirmar trabajo fiable— no está autorizado por el estado del arte cuando el objeto es convertir capacidad generativa en ejecución verificable frente a un entorno (Yao et al., 2023; Yang et al., 2024; Jimenez et al., 2024; Patil et al., 2024; Wang, L. et al., 2024; Xi et al., 2025; Liu, J. et al., 2026).
La tesis es restrictiva: esos artefactos no constituyen un arnés. El arnés —herramientas tipadas, memoria/estado, políticas de parada, verificadores, presupuestos, logging y aislamiento— convierte capacidad generativa en trabajo fiable; sin él, el modelo falla por error compuesto, tool hallucination y falta de evidencia externa. Estatus de anclaje: Yao et al. (2023) aportan un bucle razón–acción de prompt (marco/empírico de loop, no arnés de producción). Schick et al. (2023) aportan tool-use auto-supervisado como artefacto tipado, no como verificador externo. Patil et al. (2024) documentan API hallucination cuando falta evidencia de recuperación. Jimenez et al. (2024) desplazan la métrica de perplexity a issues reales de GitHub: se mide tarea, no fluidez. Yang et al. (2024) muestran, como hallazgo empírico de interfaz, que el diseño de la interfaz agente–computadora (ACI) cambia lo que el mismo tipo de modelo puede hacer. Eso autoriza a preguntar qué se midió: un completion plausible, una demo de plugin, un score de leaderboard —o un bucle que observa, actúa con tools tipadas, verifica contra evidencia externa y para bajo presupuesto.
El problema se agrava por seis confusiones de categoría. Primera: arnés no es el LLM solo —escalar no firma control (Wang, L. et al., 2024; Xi et al., 2025)—. Segunda: no es un prompt loop —ReAct (Yao et al., 2023) y Reflexion (Shinn et al., 2023) son componentes, no un harness con aislamiento y verificadores—. Tercera: no es el catálogo de APIs —Toolformer, ToolLLM, HuggingGPT y Gorilla muestran invocación, orquestación o alucinación; no equivalen a un verificador externo (Schick et al., 2023; Qin et al., 2023; Shen et al., 2023; Patil et al., 2024)—. Cuarta: no es RAG ni fine-tune: recuperar documentos o adaptar pesos no sustituye observación, parada ni logging. Quinta: no es el marketing «agent» —los surveys distinguen perfil, memoria, planificación y acción como arquitectura, no como slogan (Wang, L. et al., 2024; Sumers et al., 2023; Xi et al., 2025; Liu, J. et al., 2026)—. Sexta: no es el ranking leído como oficio: SWE-bench, AgentBench y WebArena evalúan tarea en entorno; no autorizan declarar arnés por una fila de tabla sin ACI, verificadores ni presupuestos (Jimenez et al., 2024; Liu, X. et al., 2023; Zhou et al., 2024). Inferencia: el trabajo fiable se cumple con oficio de arnés, no con escala, prompt o plugin.
Hay, además, una economía de coordinación: los artefactos caben en un anuncio; el bucle con evidencia externa, no. Las contribuciones son tres: separar oficio y artefactos; examinar casos marcados (modelo/prompt/demo; oficio de ACI, memoria, roles y presupuestos; fronteras frente a RAG, fine-tune y marketing); y ofrecer cuatro pruebas de arnés. No se inventan N, porcentajes de SWE-bench o AgentBench, d, r, AUC ni DOI: se cita la lógica de categoría de las fuentes —diseño de interfaz, evaluación de tarea, alucinación de API—, no un número fabricado.
2. Estado del arte: práctica situada vs artefacto
Conviene separar cuatro estratos que el mercado de «agentes autónomos» suele mezclar. El primero es el constructo de agente LLM como sistema que percibe un entorno, decide y actúa con herramientas, no como un completion más largo (Wang, L. et al., 2024; Sumers et al., 2023; Xi et al., 2025). El segundo es el oficio del arnés en un entorno real —interfaz agente–computadora, estado, tools tipadas, verificación, parada y presupuesto (Yang et al., 2024; Wang, X. et al., 2024; Park et al., 2023; Wang, G. et al., 2023; Wu et al., 2023)—. El tercero es la evidencia de artefactos y de tool-use —prompt loops, tools auto-supervisadas, orquestación, APIs, API hallucination— sin equivalerlos a harness de producción (Yao et al., 2023; Schick et al., 2023; Shinn et al., 2023; Shen et al., 2023; Qin et al., 2023; Patil et al., 2024). El cuarto es la evaluación con evidencia de tarea y los surveys de marco (Jimenez et al., 2024; Liu, X. et al., 2023; Zhou et al., 2024; Liu, J. et al., 2026). Inferencia: un leaderboard no observa el repositorio; un ACI con verificador sí.
En constructo y loop, Yao et al. (2023) saturan ReAct: sinergia de razonamiento y actuación en un prompt loop. Estatus: marco/empírico de bucle razón–acción; no arnés de producción con aislamiento y parada. Shinn et al. (2023) aportan Reflexion: auto-reflexión verbal como memoria efímera (componente empírico, no harness). Sumers et al. (2023) proponen CoALA: memoria, acción y grounding (marco). Wang, L. et al. (2024) organizan perfil, memoria, planificación y acción (survey de marco). Xi et al. (2025) revisan potencial y límites (survey 2025). Inferencia: el constructo autoriza a pedir arquitectura; no a vender un prompt como control.
En oficio de interfaz y de estado, Yang et al. (2024) saturan la ACI: el diseño de la interfaz agente–computadora habilita ingeniería de software automatizada. Estatus: hallazgo empírico de interfaz; no se inventan porcentajes de SWE-bench. Wang, X. et al. (2024) describen OpenHands como plataforma abierta con interfaz agente–entorno (marco/plataforma; harness de desarrollo). Wang, G. et al. (2023) aportan Voyager: curriculum, skill library y bucle abierto —oficio de estado y memoria procedural—. Park et al. (2023) articulan memoria, reflexión y planificación como arquitectura situada. Wu et al. (2023) formulan AutoGen: conversación multi-agente como arnés de coordinación. Qian et al. (2024) describen ChatDev: roles comunicativos para desarrollo de software (harness organizacional). Inferencia: el oficio no es «el modelo habló»; es la relación controlada entre modelo, entorno, memoria y roles.
En artefactos de tool-use y en evaluación, Schick et al. (2023) muestran tool-use auto-supervisado: artefacto tipado, no verificador externo. Shen et al. (2023) orquestan modelos y tools (HuggingGPT): planning + tools ≠ verificador completo. Qin et al. (2023) escalan APIs reales (ToolLLM): contraste con harness de verificación. Patil et al. (2024) documentan Gorilla: APIs masivas y API hallucination / tool calling sin evidencia. Jimenez et al. (2024) proponen SWE-bench: issues reales de GitHub (benchmark empírico de SE; medir tarea, no perplexity; no se citan tasas inventadas). Liu, X. et al. (2023) proponen AgentBench: evaluación multi-entorno. Zhou et al. (2024) proponen WebArena: entorno web realista con evidencia de tarea. Liu, J. et al. (2026) cierran con un survey TOSEM de agentes LLM en SE. Inferencia de categoría: el estado del arte distingue componente, plataforma, benchmark y survey; el mercado los aplasta en la palabra «agent».
3. Método de revisión
Se realizó una revisión narrativa crítica, no un metaanálisis primario. El propósito no fue estimar un tamaño de efecto homogéneo ni combinar tasas de SWE-bench, AgentBench o WebArena —tasas que este artículo no inventa—, sino articular un argumento de categoría: qué cuenta como arnés y qué queda en el techo de artefacto. Criterios de inclusión: (a) 2021–2026; (b) agentes LLM, tool-use, interfaces agente–computadora o agente–entorno, arquitecturas cognitivas, orquestación multi-agente, o benchmarks de tarea (SE, web, multi-entorno); (c) pares, proceedings o preprint con abs/DOI verificable el 16 de septiembre de 2026; (d) relevancia para el contraste oficio/artefacto. Se excluyeron los ejes de educación inicial de esta serie editorial, los catálogos de producto sin paper y cualquier cifra no presente en las fuentes verificadas. Se usaron las diecinueve fuentes de fuentes.md. No se añadieron autores, venues ni DOI ajenos a ese listado.
La búsqueda y la verificación se ejecutaron el 16 de septiembre de 2026 (slot America/Mexico_City) contra páginas abs de arXiv y registros Crossref del corpus. Cada fuente se leyó por el objeto que realmente mide o propone. Se distinguieron hallazgo empírico, marco e inferencia pedagógica de diseño. Cuando un artefacto —modelo solo, prompt-only, demo de tools sin loop, RAG, fine-tune o etiqueta agent— carece de ensayo verificado que lo equivalga a un arnés en producción, se discute como techo de categoría, no como hallazgo cuantitativo. No se inventaron N, d, r, AUC, porcentajes de resolución ni DOI. Las inferencias de la sección 7 son hipótesis de categoría, no un estándar industrial.
4. Caso 1. Los artefactos no constituyen apoyo
Yao et al. (2023), Schick et al. (2023) y Shen et al. (2023) saturan el techo cuando un prompt loop, un artefacto de tool-use o una orquestación se presentan como arnés de producción. Yao et al. (2023) —ReAct— cartografían razonar y actuar en el propio contexto: hallazgo de prompt loop, no de que unas trazas «Thought/Action/Observation» cultiven aislamiento, presupuestos y verificadores externos. Schick et al. (2023) —Toolformer— muestran llamadas a tools auto-supervisadas: artefacto tipado, no harness de verificación externo. Shen et al. (2023) —HuggingGPT— coordinan ChatGPT con modelos de Hugging Face: planning + tools, no verificador externo completo. Inferencia pedagógica de diseño: el gesto «el modelo llamó a una API = ya hay agente fiable» es techo de demo. Un prompt ReAct puede coexistir con ausencia de evidencia externa, de parada y de logging auditable.
Qin et al. (2023) y Patil et al. (2024) nombran el riesgo del catálogo de APIs sin oficio de verificación. Qin et al. (2023) —ToolLLM— facilitan tool-use a escala sobre APIs reales: marco/empírico; contraste con un harness de verificación. Patil et al. (2024) —Gorilla— conectan el LLM con APIs masivas y documentan API hallucination y tool calling consciente de recuperación. Estatus: hallazgo empírico de fallo cuando falta evidencia externa. Inferencia restrictiva: invocar miles de APIs no firma que la invocación sea la correcta; un caller con recuperación reduce alucinación de tool, no sustituye un verificador de tarea (tests, oráculo, evidencia web). Shinn et al. (2023) aportan Reflexion como memoria verbal. Estatus: componente; la reflexión en texto no es un oráculo externo. Inferencia: un modelo que «se corrige» en el mismo canal en el que alucina no ha salido del contexto; lo ha prolongado.
El modelo solo, el prompt-only y la demo de tools sin loop carecen, en el corpus verificado, de ensayos que autoricen a tratarlos como arnés. No se inventan porcentajes de SWE-bench ni de AgentBench para declarar que «escalar el LLM basta». Jimenez et al. (2024) miden issues reales, no fluidez: el benchmark existe porque el completion no firma el parche. Liu, X. et al. (2023) evalúan LLMs-as-agents en múltiples entornos: la evaluación supone un entorno, no un chat. Zhou et al. (2024) anclan la web realista: evidencia de tarea, no solo texto. Inferencia restrictiva: modelo ≠ control; prompt ≠ evidencia; API ≠ oficio. Wang, L. et al. (2024), Xi et al. (2025) y Liu, J. et al. (2026) mapean el campo sin equivaler el slogan de «agente autónomo» a un sistema con verificadores. Los artefactos comparten una gramática de sustitución: la escala habla por el control; el prompt por el bucle; la demo por la verificación; el marketing por la arquitectura; el ranking por el oficio de interfaz.
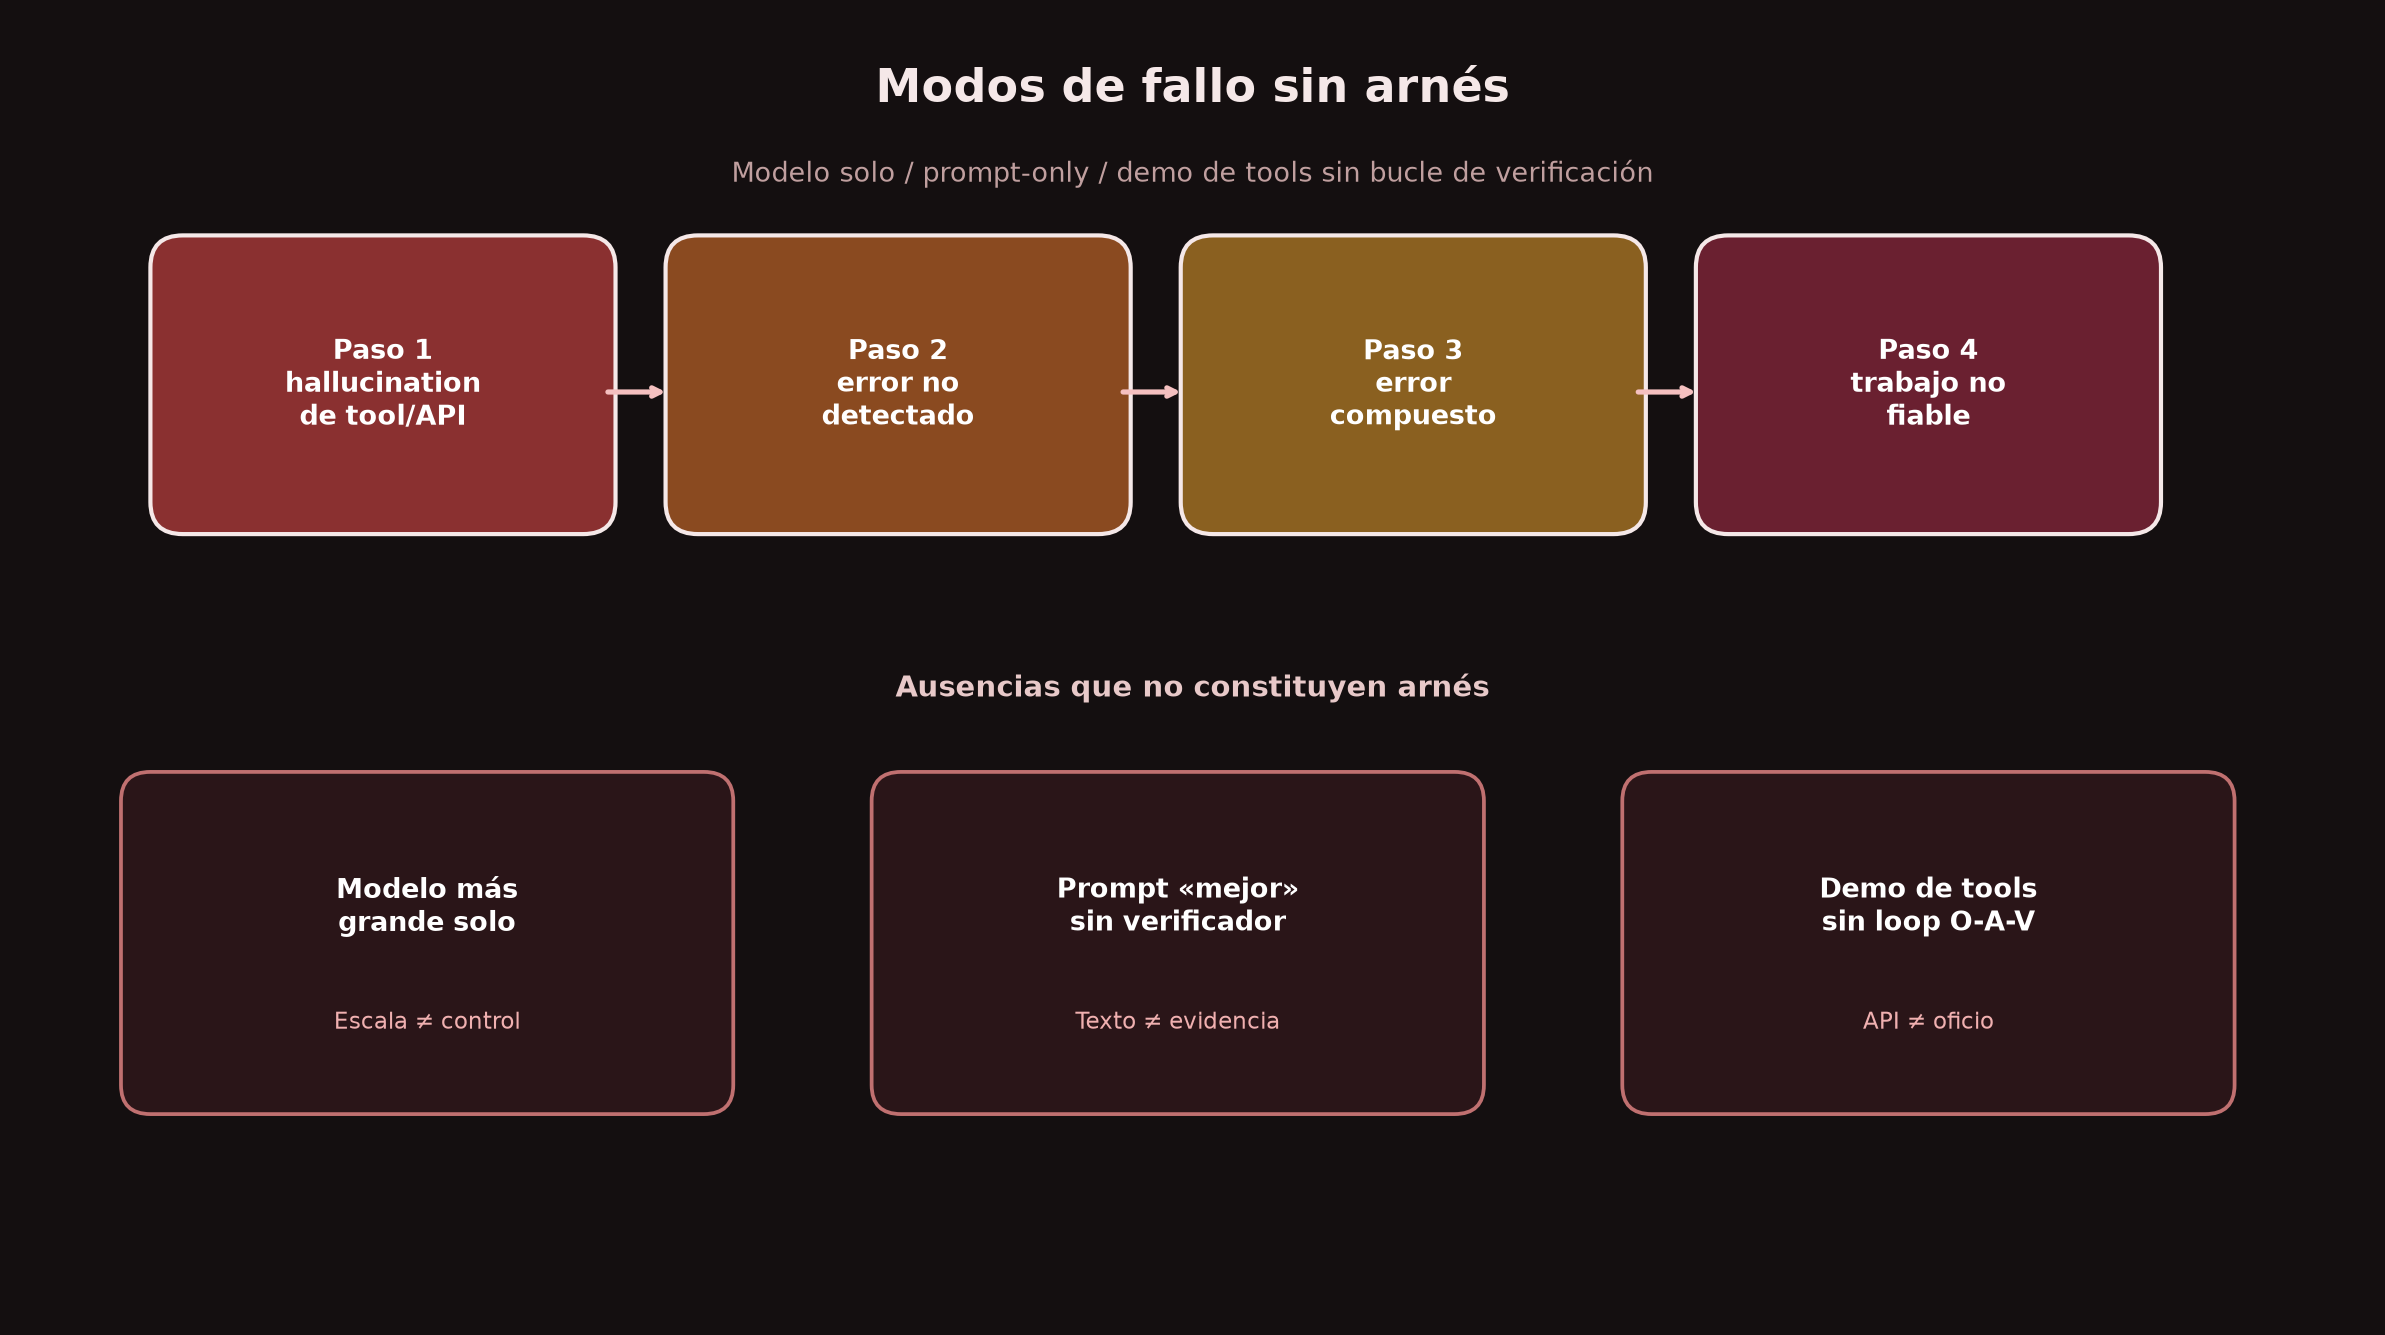
Conviene precisar el techo sin inventar efectos. Un modelo mayor puede producir trazas más coherentes; Wang, L. et al. (2024) y Xi et al. (2025) no autorizan leer esa coherencia como control. Un prompt «mejor» puede imitar ReAct; Yao et al. (2023) describen un loop de prompt, no un runtime con aislamiento. Una demo de function calling puede impresionar; Patil et al. (2024) muestran que la invocación alucinada es un modo de fallo específico. Inferencia: «el agente terminó el mensaje» o «el plugin respondió 200» no firma trabajo fiable. El error no detectado se compone: una tool alucinada produce un estado falso; el siguiente paso razona sobre ese estado; el output parece acabado y está mal. Sin verificador externo no hay quién corte la cadena. Ese es el techo de exhibición.
5. Caso 2. El oficio relacional en el jardín
El «jardín» de este caso no es un aula de educación inicial: es el entorno operativo en el que un agente de lenguaje trabaja —repositorio, navegador, API, simulador, workspace— y en el que el oficio del arnés se reconoce como práctica relacional entre modelo, herramientas, estado y evidencia externa. El piso no es un completion: es un episodio en el que el sistema observa, planifica, actúa con herramientas tipadas, verifica contra evidencia que no es el propio texto, y para cuando el presupuesto o la política lo exigen (Yang et al., 2024; Wang, X. et al., 2024; Sumers et al., 2023; Wang, G. et al., 2023). Inferencia: hay arnés cuando se protege ese bucle; no cuando se exhibe un modelo más grande, un prompt o un plugin. El modelo no «es» el agente en solitario; el agente es el acoplamiento controlado entre modelo y entorno.
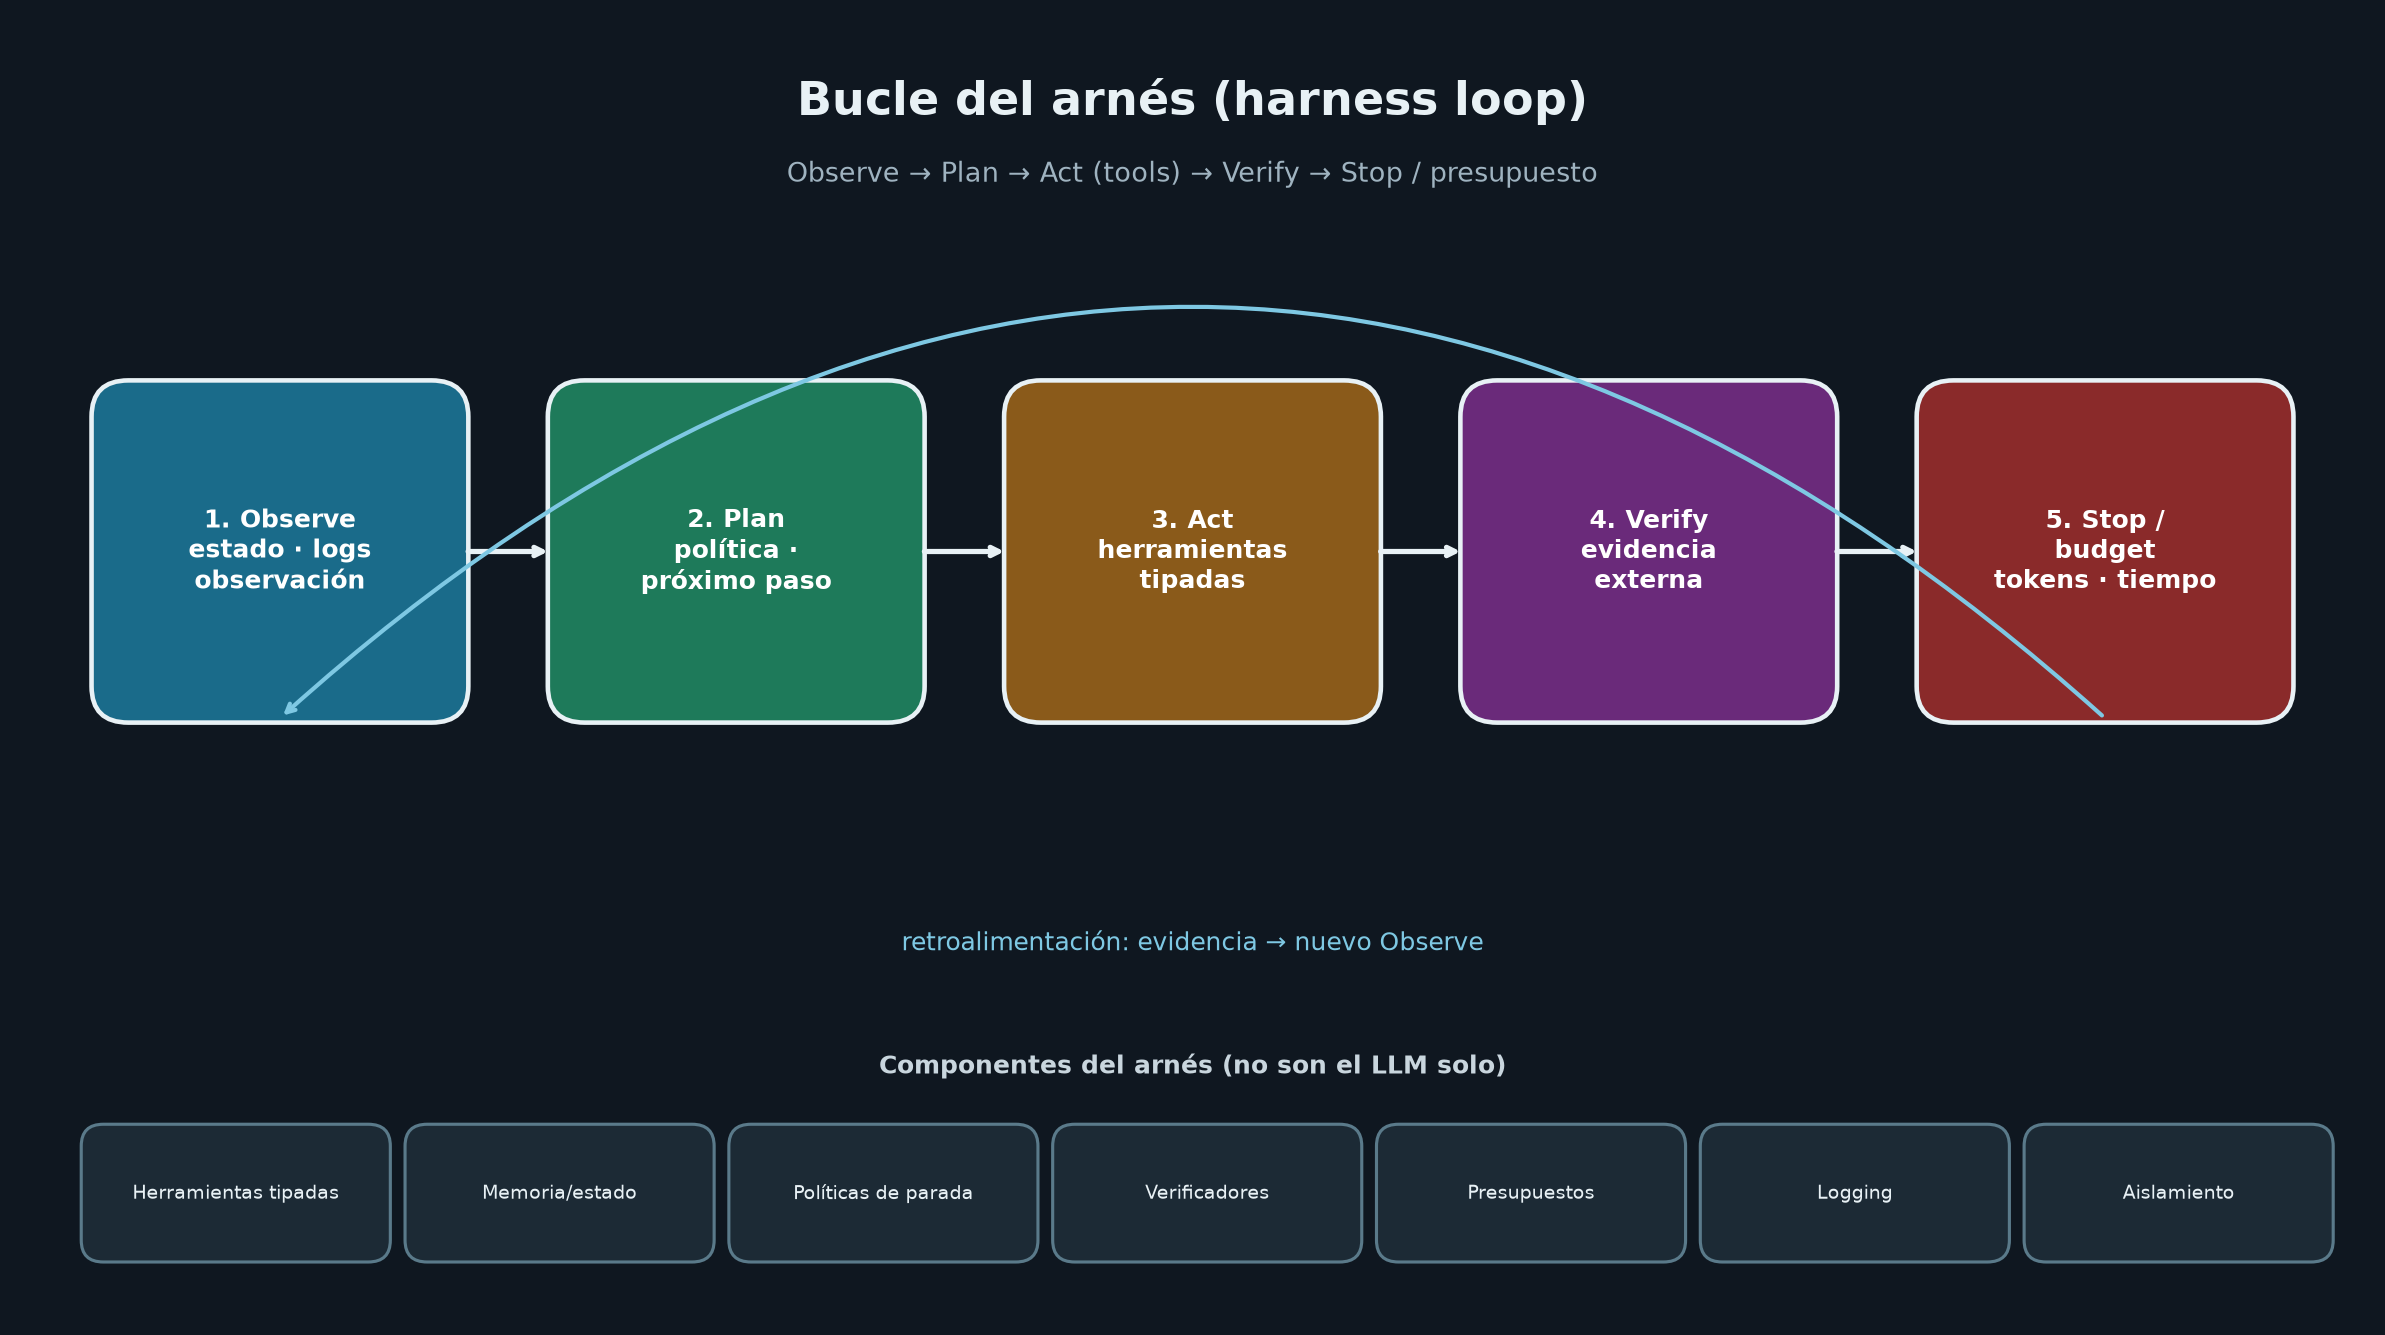
Yang et al. (2024) saturan el ancla de interfaz. SWE-agent formula que las ACI habilitan ingeniería de software automatizada: el hallazgo es de diseño —qué comandos, qué observación del repositorio, qué formato de feedback—, no de que «un LLM más grande basta». Estatus: hallazgo empírico de interfaz; no se inventan tasas de resolución. Inferencia: cambiar el arnés de interacción cambia el trabajo posible. Wang, X. et al. (2024) —OpenHands— describen una plataforma abierta para desarrolladores de software como agentes generalistas, con interfaz agente–entorno (marco de plataforma / harness de desarrollo). El oficio se institucionaliza como runtime, no como prompt pegado a un chat. Liu, J. et al. (2026) revisan agentes LLM en SE: el survey 2026 trata el campo como sistema, no como demo, y vuelve objeto al arnés.
Wang, G. et al. (2023) y Park et al. (2023) saturan el oficio de estado y de memoria. Voyager articula un agente embodied de extremo abierto con curriculum, skill library y bucle que reutiliza habilidades: oficio de memoria procedural, no un contexto que se olvida al cerrar la sesión (marco/empírico situado). Park et al. (2023) componen memoria, reflexión y planificación como arquitectura de simulacro interactivo (marco/empírico situado). Shinn et al. (2023) se releen como componente de memoria verbal que el oficio puede incorporar, no como harness completo. Sumers et al. (2023) —CoALA— dan el marco de memorias, acciones y grounding: el agente necesita anclaje, no solo tokens. Inferencia: el jardín operativo tiene estado; un chat sin memoria persistente ni grounding no es ese jardín.
Wu et al. (2023) y Qian et al. (2024) saturan el oficio de roles. AutoGen habilita aplicaciones vía conversación multi-agente: el arnés es el protocolo de quién habla, con qué tools y con qué criterio de corte (marco de coordinación). ChatDev organiza agentes comunicativos con roles para desarrollo de software: harness organizacional (diseño, código, revisión como papeles, no como slogans). Inferencia: multiplicar personajes en un prompt no es AutoGen ni ChatDev; el oficio exige roles con herramientas, memoria y parada. Un «equipo de agentes» de marketing sin aislamiento ni verificador es teatro de roles, no harness organizacional.
Jimenez et al. (2024), Liu, X. et al. (2023) y Zhou et al. (2024) anclan la evaluación del oficio, no su sustitución por un ranking. SWE-bench pregunta si los modelos resuelven issues reales de GitHub: la unidad es la tarea con tests, no la perplexity. AgentBench evalúa LLMs-as-agents en varios entornos. WebArena ofrece un entorno web realista con evidencia de tarea. Estatus: benchmarks empíricos de entorno. Inferencia restrictiva: citarlos sin describir ACI, verificadores y presupuestos es exhibir el jardín vacío. El oficio se verifica cuando el bucle deja rastro —logs, diffs, oráculos, paradas—, no cuando el modelo produce un párrafo sobre lo que «habría hecho».
6. Caso 3. Fronteras de categoría
La primera frontera es RAG: recuperar pasajes puede reducir alucinación factual; no observa un repositorio, no ejecuta un parche, no verifica un test ni implementa parada. Patil et al. (2024) muestran que el tool calling exige evidencia de recuperación; eso no convierte a RAG en arnés. Inferencia: «tenemos embeddings = tenemos agente» no firma. La segunda es el fine-tune: adaptar pesos puede cambiar el estilo de invocación; Schick et al. (2023) enseñan tools en el modelo; el checkpoint no es un runtime con aislamiento y logging. Inferencia: un modelo afinado sigue siendo modelo; el arnés es el sistema alrededor. La tercera es el prompt loop: ReAct y Reflexion (Yao et al., 2023; Shinn et al., 2023) son piezas; Sumers et al. (2023) y Wang, L. et al. (2024) piden arquitectura. Inferencia: una plantilla Thought/Action no es CoALA ni una ACI.
La cuarta frontera es la orquestación y el catálogo de APIs. HuggingGPT (Shen et al., 2023) planifica y despacha expertos; ToolLLM (Qin et al., 2023) escala el dominio de APIs. Estatus: marcos/empíricos de orquestación y de tool-use a escala. Inferencia de categoría: planning + tools ≠ verificador externo completo; un catálogo masivo ≠ oficio de verificación. Un despachador puede elegir mal el experto; un catálogo puede invocarse de forma alucinada (Patil et al., 2024). La quinta es el marketing de «agent»: Xi et al. (2025) y Wang, L. et al. (2024) describen potencial y límites; Liu, J. et al. (2026) sitúan el campo en SE. Ninguno autoriza a etiquetar como agente un chatbot con memoria de hilo. La sexta es el leaderboard como oficio: Jimenez et al. (2024), Liu, X. et al. (2023) y Zhou et al. (2024) construyen entornos y tareas; Yang et al. (2024) y Wang, X. et al. (2024) muestran que la interfaz es parte del sistema evaluado. Inferencia: una fila de tabla sin descripción de harness no distingue modelo, prompt y arnés.
Quedan fronteras internas del oficio. Memoria y skill library (Wang, G. et al., 2023; Park et al., 2023) son componentes: sin verificador y sin presupuesto pueden memorizar el error. Roles multi-agente (Wu et al., 2023; Qian et al., 2024) son harness organizacional solo si hay protocolo, tools y corte; si no, son diálogo. Un entorno embodied o web (Wang, G. et al., 2023; Zhou et al., 2024) es jardín operativo, no licencia para omitir aislamiento. Inferencia pedagógica de diseño: la categoría «arnés» es conjuntiva —loop con evidencia externa, tools tipadas y aislamiento, parada/presupuesto/logging, y juicio de diseño—. Falta una pieza y el sistema recae en artefacto, aunque el slide diga agent.
7. Cuatro pruebas de apoyo (no artefacto)
El marco que sigue es inferencia pedagógica de diseño de este artículo, anclada en los casos y en las fuentes verificadas. No es un estándar ISO ni un leaderboard. Distingue cuatro pruebas. Si una plataforma o un producto no las pasa, no puede declarar que el modelo solo, el prompt-only, la demo de tools, el RAG, el fine-tune o la etiqueta agent constituyen un arnés.
7.1. Prueba del bucle observación–acción–verificación con evidencia externa, no del modelo solo ni del prompt loop sin oráculo. Yao et al. (2023) definen un loop de prompt; Shinn et al. (2023) añaden reflexión verbal; Sumers et al. (2023) exigen grounding; Jimenez et al. (2024), Liu, X. et al. (2023) y Zhou et al. (2024) evalúan con evidencia de tarea. Inferencia: el apoyo se verifica cuando hay Observe → Act → Verify contra tests, workspace, página web o oráculo que no es el propio token. Si la «evidencia» es que el modelo escribió «listo» o que el prompt incluye la palabra Observation, hay teatro de bucle, no arnés.
7.2. Prueba de herramientas tipadas y aislamiento, no del catálogo de APIs ni de la demo de function calling. Schick et al. (2023) tipan la invocación; Qin et al. (2023) y Shen et al. (2023) escalan y orquestan; Patil et al. (2024) muestran API hallucination; Yang et al. (2024) y Wang, X. et al. (2024) sitúan interfaz y aislamiento. Inferencia: hay arnés cuando las tools tienen esquema, permisos y sandbox, y una invocación alucinada no tiene acceso irrestricto al mundo. Un plugin en el chat no firma esa prueba. Aislar no es estética: es admitir el modo de fallo que Gorilla nombra.
7.3. Prueba de políticas de parada, presupuestos de tokens/tiempo y logging, no del agente que «sigue intentando» hasta agotar la tarjeta. Wu et al. (2023) y Qian et al. (2024) coordinan con roles y corte; Wang, G. et al. (2023) y Park et al. (2023) sostienen bucles abiertos con memoria y curriculum, no con gasto ilimitado; Xi et al. (2025) marcan límites. Inferencia: un sistema sin presupuesto ni log auditable no es fiable aunque resuelva una demo. La parada es oficio: saber cuándo no se sabe y cuándo el verificador falló. El logging es memoria externa que Reflexion no sustituye.
7.4. Prueba de la distinción de categoría y del juicio de diseño, no del catálogo de producto. Arnés ≠ LLM solo ≠ prompt-only ≠ demo de tools ≠ RAG ≠ fine-tune ≠ marketing de «agent» ≠ fila de leaderboard. Wang, L. et al. (2024), Xi et al. (2025) y Liu, J. et al. (2026) impiden reducir el campo a un slogan. Yang et al. (2024) impiden omitir la interfaz. Inferencia: un laboratorio no puede tratar al modelo como si fuera el sistema ni al ranking como si fuera el oficio. El trabajo fiable se cumple diseñando el acoplamiento modelo–entorno con las tres pruebas anteriores y declarando qué pieza falta.
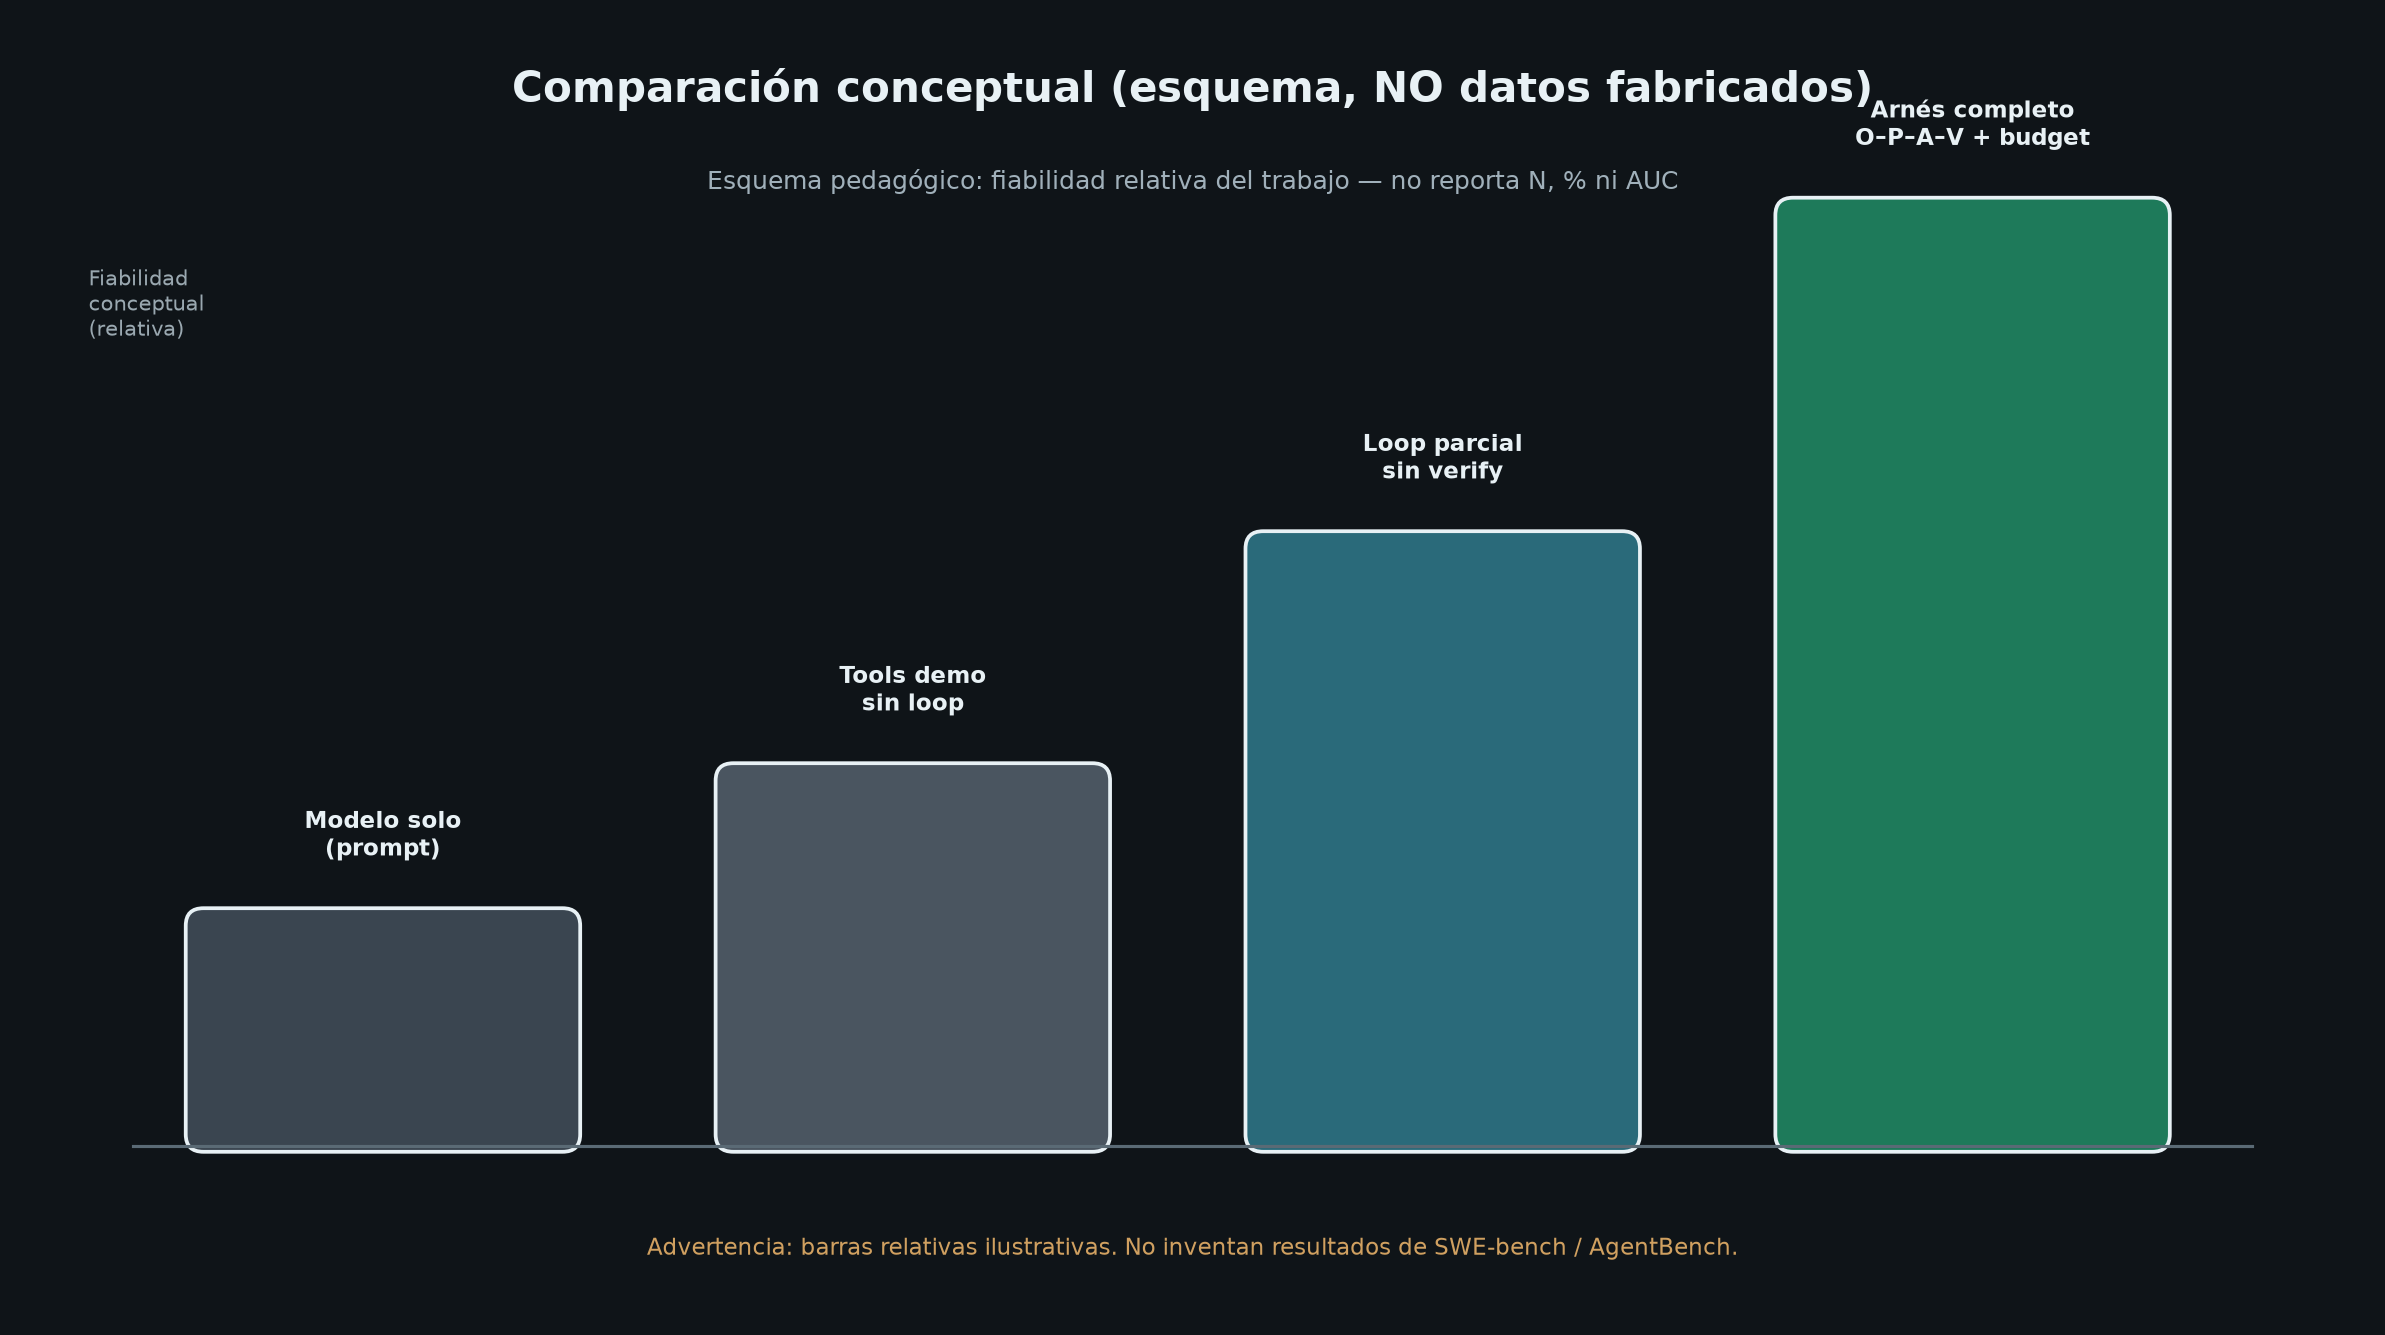
El marco admite componentes subordinados —ReAct, Toolformer, Reflexion, RAG, fine-tune, HuggingGPT, ToolLLM— como piezas (Yao et al., 2023; Schick et al., 2023; Shinn et al., 2023; Shen et al., 2023; Qin et al., 2023). Rechaza declarar arnés por cualquiera de ellos en solitario, y rechaza leer Gorilla, SWE-bench, AgentBench o WebArena como licencia para omitir verificadores (Patil et al., 2024; Jimenez et al., 2024; Liu, X. et al., 2023; Zhou et al., 2024). Las cuatro pruebas se leen en conjunto.
8. Discusión
Tres tensiones organizan la discusión. La primera es entre exhibir los artefactos y ejercer el oficio del arnés. Yao et al. (2023), Schick et al. (2023), Shen et al. (2023) y Qin et al. (2023) sostienen componentes reales —loop, tools, orquestación, APIs— que el mercado infla hasta hacerlos pasar por sistema. Yang et al. (2024), Wang, X. et al. (2024), Wu et al. (2023) y Qian et al. (2024) sostienen el contraste: interfaz, plataforma, roles. Inferencia: la pieza es verdadera en su dominio; «pieza = arnés de producción» es una inferencia de categoría ilegítima.
La segunda es entre escalar el LLM y diseñar la interfaz. Xi et al. (2025) y Wang, L. et al. (2024) describen el auge de agentes basados en modelos más capaces; Yang et al. (2024) muestran que la ACI es un objeto de diseño empírico; Jimenez et al. (2024) miden issues, no tokens predichos. La tesis es estricta: la ganancia empírica reportada en la literatura de agentes no se lee con honestidad si se atribuye solo a la escala y se oculta el arnés. Inferencia: omitir el harness en el relato causal es un sesgo de exhibición, no una conclusión de SWE-bench.
La tercera es entre tool hallucination y evidencia externa. Patil et al. (2024) nombran el fallo; Zhou et al. (2024) y Jimenez et al. (2024) construyen entornos donde la evidencia no es el propio contexto; Sumers et al. (2023) piden grounding; Shinn et al. (2023) muestran que la reflexión verbal no sale del lenguaje. Inferencia: el modo de fallo no es «el modelo es tonto»; es que, sin oráculo, el error no se ve. Voyager y los agentes generativos (Wang, G. et al., 2023; Park et al., 2023) ilustran que memoria y curriculum sostienen bucles abiertos. Liu, J. et al. (2026) recuerdan que en SE el agente se juega en el parche y en el test, no en la prosa del commit.
Las cuatro pruebas leen estas tensiones. El contraste de interfaz y de benchmark define el piso que los artefactos no alcanzan solos. Un prompt ReAct, un caller tipo Gorilla, un rol de AutoGen o una skill de Voyager pueden vivir dentro del arnés; no lo es invertir la secuencia: primero el anuncio de «agente autónomo», después la esperanza de que el modelo se verifique solo (Xi et al., 2025; Wang, L. et al., 2024). Si hay logs, tools tipadas, oráculo y parada, hay arnés; si solo hay escala, prompt o plugin, hay artefactos.
9. Límites
Esta revisión es narrativa. No aplica PRISMA propio ni estima efectos combinados. No se inventan porcentajes de SWE-bench, AgentBench, WebArena ni SWE-agent; no se inventan N, d, r ni AUC. Yao et al. (2023), Schick et al. (2023), Shinn et al. (2023), Shen et al. (2023), Qin et al. (2023) y Patil et al. (2024) se leen por el objeto que proponen (loop, tools, reflexión, orquestación, APIs, hallucination), no como ensayos del paquete «agente de producción». Yang et al. (2024) y Wang, X. et al. (2024) anclan interfaz y plataforma: no se generalizan a todo dominio. Jimenez et al. (2024), Liu, X. et al. (2023) y Zhou et al. (2024) son benchmarks de entorno. Wang, G. et al. (2023) y Park et al. (2023) son entornos embodied o de simulacro: transferencia de escenario marcada. Wu et al. (2023) y Qian et al. (2024) son coordinación y roles. Sumers et al. (2023), Wang, L. et al. (2024), Xi et al. (2025) y Liu, J. et al. (2026) son marcos y surveys, no un trial del techo de artefactos.
No se localizaron, en el corpus de este kit, ensayos que equivalgan modelo solo, prompt-only o demo de tools sin loop a un arnés de observación–acción–verificación con aislamiento; se discuten como techo de categoría. Varias fuentes son preprints arXiv con abs verificada: se citan como tales, sin inventar DOI. No se evalúan productos comerciales ni leaderboards. Las inferencias de la sección 7 son hipótesis de categoría, no evidencia de un runtime particular. El «jardín» del encabezado 5 nombra el entorno operativo; no transfiere hallazgos de educación inicial.
10. Conclusiones
Un modelo más grande, un prompt «mejor» o una demo de tools sin bucle de observación–acción–verificación no constituyen un arnés. Tampoco lo constituyen, por sí solos, un RAG, un fine-tune, una etiqueta agent ni una fila de leaderboard sin interfaz, verificadores y presupuestos. Yao et al. (2023), Schick et al. (2023), Shinn et al. (2023), Shen et al. (2023) y Qin et al. (2023) confirman componentes —loop, tools, reflexión, orquestación, APIs— sin equivalencia a harness de producción. Patil et al. (2024) confirman API hallucination cuando falta evidencia. Wang, L. et al. (2024), Xi et al. (2025) y Liu, J. et al. (2026) fijan el mapa y los límites. Cuando hay arnés hay oficio situado: ACI (Yang et al., 2024); plataforma agente–entorno (Wang, X. et al., 2024); memoria y skill library (Wang, G. et al., 2023; Park et al., 2023); roles (Wu et al., 2023; Qian et al., 2024); grounding (Sumers et al., 2023); evaluación con evidencia de tarea (Jimenez et al., 2024; Liu, X. et al., 2023; Zhou et al., 2024). El arnés se distingue del LLM solo, del prompt-only, de la demo de tools, del RAG, del fine-tune y del slogan.
Donde las fuentes no miden un runtime de producción, este artículo no lo afirma. Donde miden loops, tools, benchmarks, plataformas o surveys, no los traduce en «el modelo ya es un agente fiable» vía escala o vía demo. Convertir capacidad generativa en trabajo fiable es ejercer tools tipadas, memoria/estado, parada, verificadores, presupuestos, logging y aislamiento, en un bucle que observa, actúa y verifica contra evidencia externa. Lo demás es modelo solo, prompt-only y tool demo sin loop. No es arnés, y no debe presentarse como lo que no es.
Laboratorio Editorial de NEXTECH.IA / Ingeniero Mitre.
Referencias
- Jimenez, C. E., Yang, J., Wettig, A., Yao, S., Pei, K., Press, O., y Narasimhan, K. (2024). SWE-bench: Can language models resolve real-world GitHub issues? arXiv. https://arxiv.org/abs/2310.06770
- Liu, J., Wang, K., Chen, Y., Peng, X., Chen, Z., Zhang, L., y Lou, Y. (2026). Large language model-based agents for software engineering: A survey. ACM Transactions on Software Engineering and Methodology. https://doi.org/10.1145/3796507
- Liu, X., Yu, H., Zhang, H., Xu, Y., Lei, X., Lai, H., Gu, Y., Ding, H., Men, K., Yang, K., Zhang, S., Deng, X., Zeng, A., Du, Z., Zhang, C., Shen, S., Zhang, T., Su, Y., Sun, H., Huang, M., Dong, Y., y Tang, J. (2023). AgentBench: Evaluating LLMs as agents. arXiv. https://arxiv.org/abs/2308.03688
- Park, J. S., O’Brien, J. C., Cai, C. J., Morris, M. R., Liang, P., y Bernstein, M. S. (2023). Generative agents: Interactive simulacra of human behavior. En Proceedings of the 36th Annual ACM Symposium on User Interface Software and Technology (pp. 1–22). ACM. https://doi.org/10.1145/3586183.3606763
- Patil, S. G., Zhang, T., Wang, X., y Gonzalez, J. E. (2024). Gorilla: Large language model connected with massive APIs. En Advances in Neural Information Processing Systems 37. https://doi.org/10.52202/079017-4020
- Qian, C., Liu, W., Liu, H., Chen, N., Dang, Y., Li, J., Yang, C., Chen, W., Su, Y., Cong, X., Xu, J., Li, D., Liu, Z., y Sun, M. (2024). ChatDev: Communicative agents for software development. En Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) (pp. 15174–15186). Association for Computational Linguistics. https://doi.org/10.18653/v1/2024.acl-long.810
- Qin, Y., Liang, S., Ye, Y., Zhu, K., Yan, L., Lu, Y., Lin, Y., Cong, X., Tang, X., Qian, B., Zhao, S., Hong, L., Tian, R., Xie, R., Zhou, J., Gerstein, M., Li, D., Liu, Z., y Sun, M. (2023). ToolLLM: Facilitating large language models to master 16000+ real-world APIs. arXiv. https://arxiv.org/abs/2307.16789
- Schick, T., Dwivedi-Yu, J., Dessì, R., Raileanu, R., Lomeli, M., Hambro, E., Zettlemoyer, L., Cancedda, N., y Scialom, T. (2023). Toolformer: Language models can teach themselves to use tools. En Advances in Neural Information Processing Systems 36. https://doi.org/10.52202/075280-2997
- Shen, Y., Song, K., Tan, X., Li, D., Lu, W., y Zhuang, Y. (2023). HuggingGPT: Solving AI tasks with ChatGPT and its friends in Hugging Face. En Advances in Neural Information Processing Systems 36. https://doi.org/10.52202/075280-1657
- Shinn, N., Cassano, F., Gopinath, A., Narasimhan, K., y Yao, S. (2023). Reflexion: Language agents with verbal reinforcement learning. En Advances in Neural Information Processing Systems 36. https://doi.org/10.52202/075280-0377
- Sumers, T. R., Yao, S., Narasimhan, K., y Griffiths, T. L. (2023). Cognitive architectures for language agents. arXiv. https://arxiv.org/abs/2309.02427
- Wang, G., Xie, Y., Jiang, Y., Mandlekar, A., Xiao, C., Zhu, Y., Fan, L., y Anandkumar, A. (2023). Voyager: An open-ended embodied agent with large language models. arXiv. https://arxiv.org/abs/2305.16291
- Wang, L., Ma, C., Feng, X., Zhang, Z., Yang, H., Zhang, J., Chen, Z., Tang, J., Chen, X., Lin, Y., Zhao, W. X., Wei, Z., y Wen, J. (2024). A survey on large language model based autonomous agents. Frontiers of Computer Science, 18(6), Article 186345. https://doi.org/10.1007/s11704-024-40231-1
- Wang, X., Li, B., Song, Y., Xu, F. F., Tang, X., Zhuge, M., Pan, J., Song, Y., Chan, B., Ding, J., Li, J., Geng, H., Li, A., Yang, J., Li, M., Wang, Z., Yu, A., Yang, N., Tang, N., y Neubig, G. (2024). OpenHands: An open platform for AI software developers as generalist agents. arXiv. https://arxiv.org/abs/2407.16741
- Wu, Q., Bansal, G., Zhang, J., Wu, Y., Li, B., Zhu, E., Jiang, L., Zhang, X., Zhang, S., Liu, J., Awadallah, A. H., White, R. W., Burger, D., y Wang, C. (2023). AutoGen: Enabling next-gen LLM applications via multi-agent conversation. arXiv. https://arxiv.org/abs/2308.08155
- Xi, Z., Chen, W., Guo, X., He, W., Ding, Y., Hong, B., Zhang, M., Wang, J., Jin, S., Zhou, E., Zheng, R., Fan, X., Wang, X., Xiong, L., Zhou, Y., Wang, W., Jiang, C., Zou, Y., Liu, X., Yin, Z., Dou, S., Weng, R., Cheng, W., Zhang, Q., Qin, W., Zheng, Y., Qiu, X., Huang, X., y Gui, T. (2025). The rise and potential of large language model based agents: A survey. Science China Information Sciences, 68(2), Article 121101. https://doi.org/10.1007/s11432-024-4222-0
- Yang, J., Jimenez, C. E., Wettig, A., Lieret, K., Yao, S., Narasimhan, K., y Press, O. (2024). SWE-agent: Agent-computer interfaces enable automated software engineering. En Advances in Neural Information Processing Systems 37. https://doi.org/10.52202/079017-1601
- Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K., y Cao, Y. (2023). ReAct: Synergizing reasoning and acting in language models. arXiv. https://arxiv.org/abs/2210.03629
- Zhou, S., Xu, F. F., Zhu, H., Zhou, X., Lo, R., Sridhar, A., Cheng, X., Ou, T., Bisk, Y., Fried, D., Alon, U., y Neubig, G. (2024). WebArena: A realistic web environment for building autonomous agents. arXiv. https://arxiv.org/abs/2307.13854